


コンポジットメディアサーバーでのリアルタイム生成AIの探求


"私の研究では、リアルタイムの映像制作において、画像の生成・解析を行うAIモデルをどのように統合し、制御するか、そしてそれを支えるアーキテクチャに焦点を当てています。"
"私の研究では、リアルタイムの映像制作において、画像の生成・解析を行うAIモデルをどのように統合し、制御するか、そしてそれを支えるアーキテクチャに焦点を当てています。"
本記事では、SMODEを長年使用してきたRomain Delaplaceの実践を通して、リアルタイムのクリエイティブソフトウェアに生成AIを統合する取り組みを紹介します。Romainは、SMODEの環境でStreamDiffusionとControlNetを活用し、さまざまな構成やパラメーターを試してきました。その検証からは、利用できるハードウェアリソースによって結果が変わることが明らかになり、今後の開発に向けた具体的な可能性も見えてきました。SMODEへのStreamDiffusionの統合は、ソフトウェア内で生成AIをより幅広く活用していくための第一歩です。
ライブイベントのためのリアルタイムAI映像制作:SMODEが開く新たな可能性
ビジュアルアーティスト、VJ、舞台演出家の皆さんなら、テキストの指示によってライブ映像のスタイルを変える生成AIの表現力を、すでに目にしたことがあるかもしれません。では、その技術を、パフォーマンスの流れを止めずにライブの現場へ取り入れるにはどうすればよいのでしょうか。
これまでの方法では、十分とは言えませんでした。たとえば、ComfyUIではAI生成を細かく制御できますが、そのパイプラインは主にオフラインで試行錯誤を重ねるためのもので、瞬時の対応が求められるライブステージを前提としたものではありません。ここに大きな課題があります。主要なコンポジットツールの標準機能では、AI生成をリアルタイムの処理で扱うことが難しいのです。
SMODEは、ライブ映像の制作、イベント、舞台演出、没入型インスタレーションに対応する、リアルタイム2D/3Dコンポジットソフトウェアです。コミュニティ版は無料で利用でき、プロフェッショナル向けメディアサーバーとして使用するための商用版も提供されています。
SMODEは、AIの取り入れ方においても他の映像制作ツールとは異なる特徴を持っています。ComfyUIではAIによる生成を中心に処理を組み立て、TouchDesignerではAIを処理の流れに接続するノードの一つとして扱います。一方SMODEでは、既存のリアルタイム映像制作の機能の一つとしてAIによる生成・加工を取り入れ、他の映像素材やエフェクトと組み合わせながら活用できます。
2025年5月にリリースされたバージョンR13から、SMODEにはStreamDiffusionモジュールが搭載されています。このモジュールでは、静止画や連続した映像ストリームを入力し、テキストプロンプトに基づいてAI画像を生成できます。プロンプトとは、AIに生成してほしい内容を文章で記述した指示のことです。
StreamDiffusionは、コンポジション内に新たなコンテンツを作り出す「生成ツール」としても、既存の要素を変化させる「モディファイア」としても、SMODEに標準で組み込まれています。
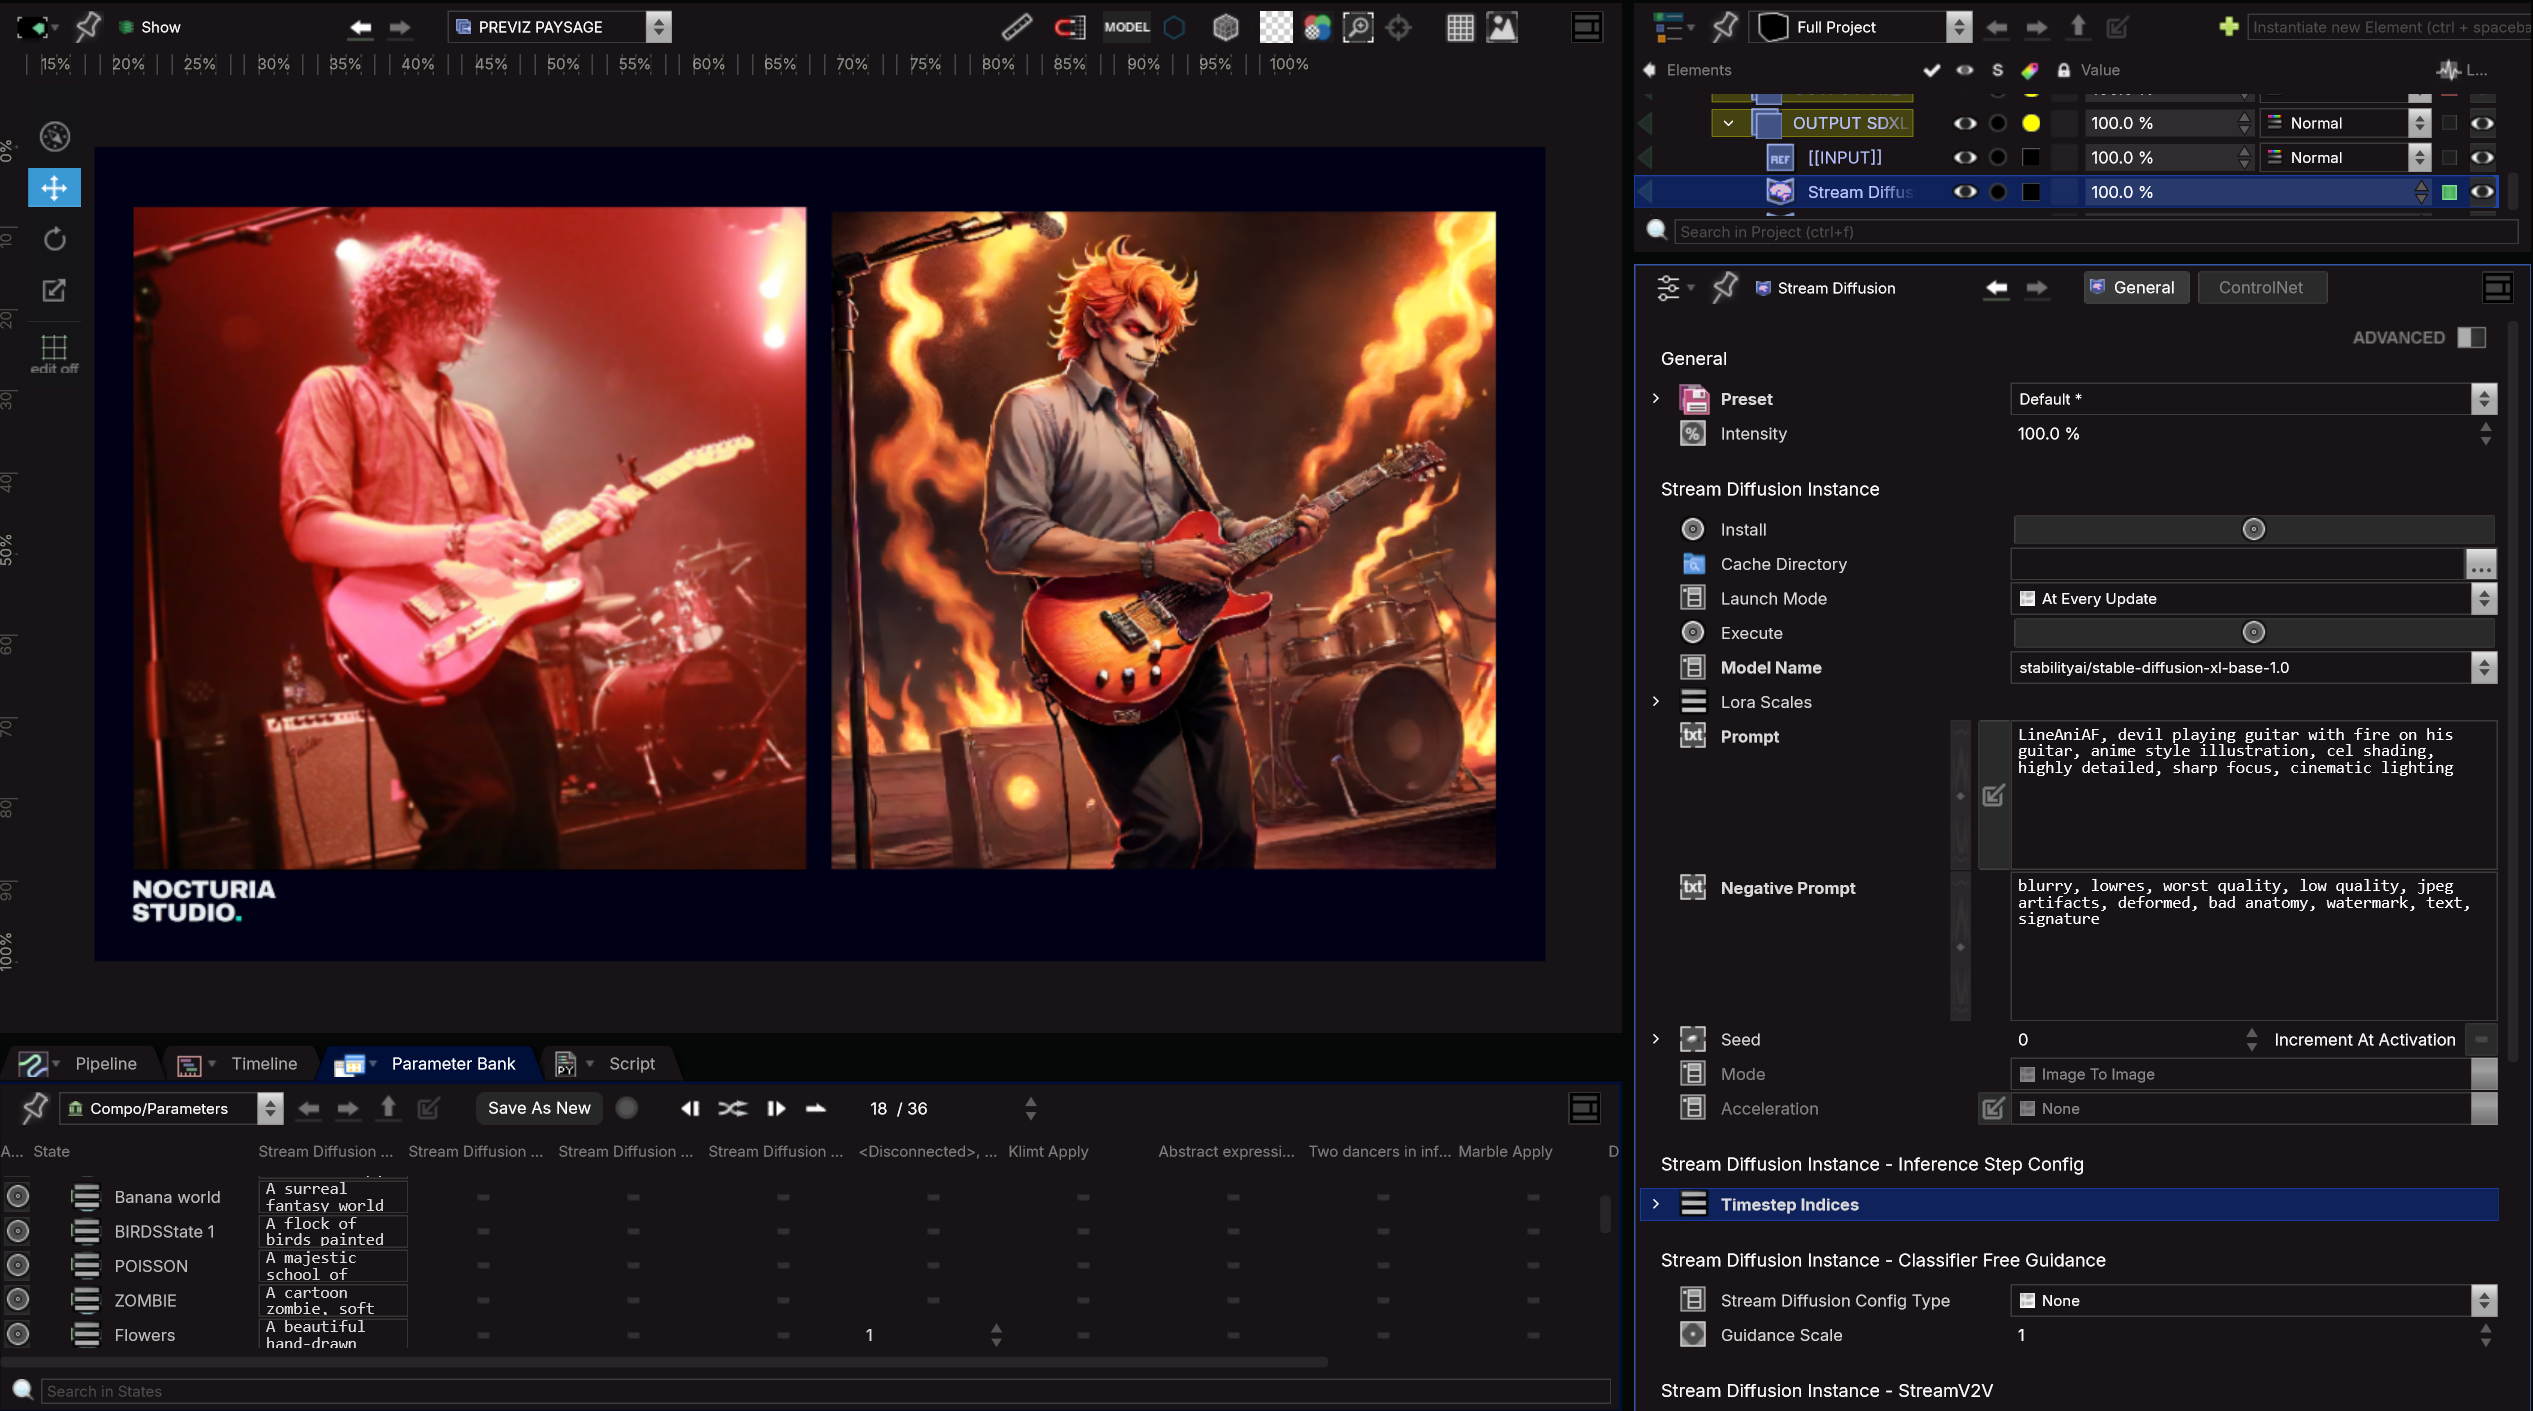
写真提供: Nocturia Studio
Romain Delaplaceと探る、StreamDiffusion × SMODEの第一歩
Romain Delaplaceは、2009年から舞台芸術とデジタル技術に情熱を注いできました。照明から映像へと活動の幅を広げ、現在はSMODEを活用するマルチメディアプログラマー兼コンテンツクリエイターとして活躍しています。
Nocturia Studioでは、芸術と技術の両面にわたる専門性を生かし、作品の構想から技術面での実装・納品まで、制作のあらゆる段階に携わっています。
2016年からSMODEを使用しているRomainは、条件や要求が大きく異なるさまざまな現場で、このソフトウェアを活用してきました。The VoiceやStar Academyといったテレビ番組をはじめ、GimsのFuego Tour、Pascal Obispoのコンサート、MYD Live Experienceなど、高度な技術対応が求められる大規模なライブ公演にも参加しています。
活動は没入型体験の分野にも広がり、Beyond Van Gogh、Monet、Les Misérables、La Haineといった作品で、あらゆる面を表現のキャンバスへと変えています。
こうした分野横断的な経験は、現代の制作現場を支える大きな強みです。ツールを使いこなす技術に加え、プロジェクト全体を見渡す視点も求められるからです。
写真提供: Anthony Ghnassia, La Haine show
実験と検証
目指す映像表現に適した構成を見つけるには、プロンプトと各種パラメーターを調整しながら、試行錯誤を重ねる必要があります。
こうした調整に入る前に、軽量なモデルやStable Diffusion 1.5のような旧世代のモデルに、近年のLoRAを組み合わせることで、表現のベースとなるスタイルを作ることもできます。LoRAは、AIモデル全体を再学習させずに、その特性を調整できる小さな追加モジュールです。少ない負荷で、素早く新たなスタイルを加えられます。
今回は、テキストプロンプトを使ったシンプルな比較実験を行いました。
各テストでは、元となる映像をStreamDiffusionに入力し、目指す雰囲気を記述したテキストプロンプトを適用します。その映像を、SD Turbo、SDXL、SD 1.5 + LoRA Hyper SD、Hyper SDXLという4種類のAIモデルで、リアルタイムに変換しました。
すべてのテストで設定は同一とし、TensorRTやxFormersなど、AI処理を高速化する仕組みは使用していません。比較するグループごとに変更したのは、プロンプトのみです。また、生成時のデノイズは1ステップで行っています。
デノイズは、拡散モデルの中心となる仕組みです。モデルはランダムなノイズを出発点として、段階的にノイズを取り除きながら、まとまりのある画像を作り出します。ステップ数を増やすほど細部を整える余地が生まれますが、その分、処理時間と必要な計算リソースも増加します。

使用したGPU:NVIDIA RTX 5080
実験:スタイルとテキストプロンプト
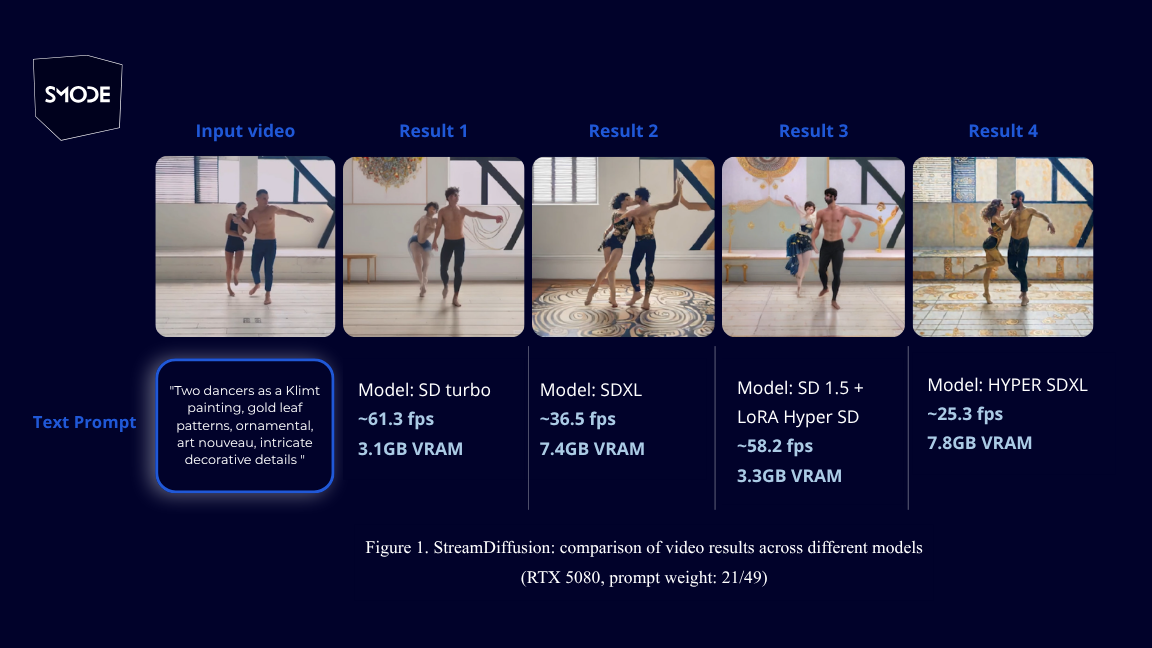
- 最初の比較では、グスタフ・クリムトに着想を得た、金色の絵画表現や装飾的な模様を促すプロンプトを使用しました。目的は、ライブで使用できる滑らかさを保ちながら、元の映像を絵画調に変換することです。
写真提供: Anthony Ghnassia, La Haine show
実験と検証
目指す映像表現に適した構成を見つけるには、プロンプトと各種パラメーターを調整しながら、試行錯誤を重ねる必要があります。
こうした調整に入る前に、軽量なモデルやStable Diffusion 1.5のような旧世代のモデルに、近年のLoRAを組み合わせることで、表現のベースとなるスタイルを作ることもできます。LoRAは、AIモデル全体を再学習させずに、その特性を調整できる小さな追加モジュールです。少ない負荷で、素早く新たなスタイルを加えられます。
今回は、テキストプロンプトを使ったシンプルな比較実験を行いました。
各テストでは、元となる映像をStreamDiffusionに入力し、目指す雰囲気を記述したテキストプロンプトを適用します。その映像を、SD Turbo、SDXL、SD 1.5 + LoRA Hyper SD、Hyper SDXLという4種類のAIモデルで、リアルタイムに変換しました。
すべてのテストで設定は同一とし、TensorRTやxFormersなど、AI処理を高速化する仕組みは使用していません。比較するグループごとに変更したのは、プロンプトのみです。また、生成時のデノイズは1ステップで行っています。
デノイズは、拡散モデルの中心となる仕組みです。モデルはランダムなノイズを出発点として、段階的にノイズを取り除きながら、まとまりのある画像を作り出します。ステップ数を増やすほど細部を整える余地が生まれますが、その分、処理時間と必要な計算リソースも増加します。
使用したGPU:NVIDIA RTX 5080
実験:スタイルとテキストプロンプト
- 最初の比較では、グスタフ・クリムトに着想を得た、金色の絵画表現や装飾的な模様を促すプロンプトを使用しました。目的は、ライブで使用できる滑らかさを保ちながら、元の映像を絵画調に変換することです。
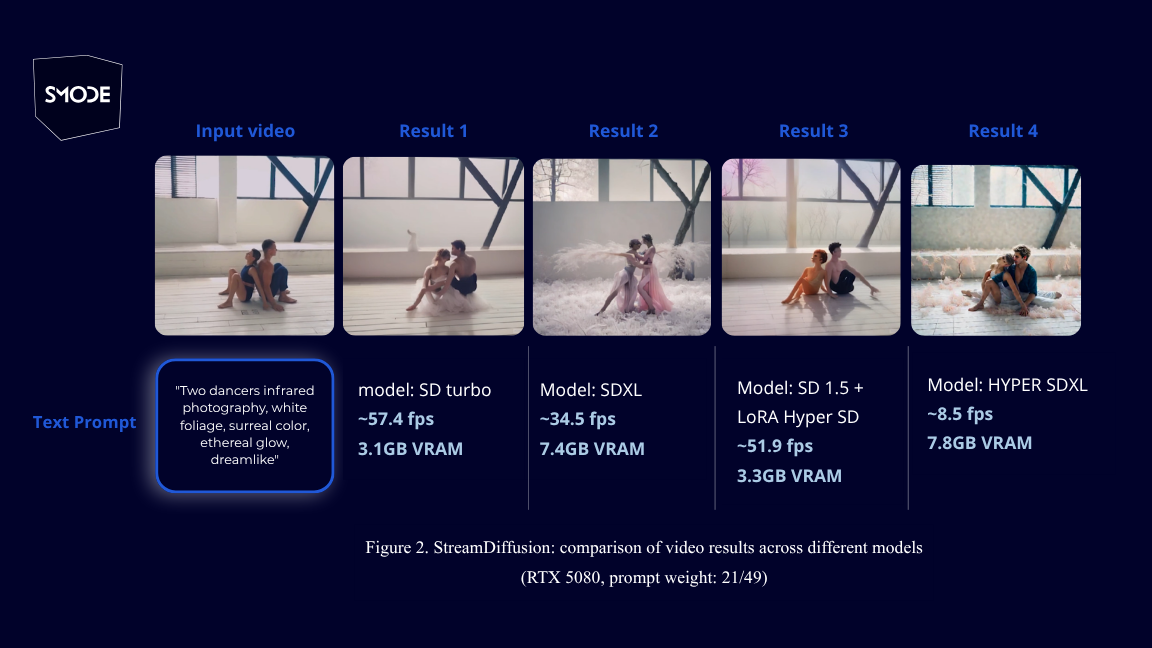
2. 次のプロンプトでは、赤い色調を強調し、印象の強い映像を目指しました。「surreal color」という表現で豊かで彩度の高い色彩へと導き、「dreamlike」や「glow」といった語で、柔らかく幻想的な雰囲気を加えています。
2. 次のプロンプトでは、赤い色調を強調し、印象の強い映像を目指しました。「surreal color」という表現で豊かで彩度の高い色彩へと導き、「dreamlike」や「glow」といった語で、柔らかく幻想的な雰囲気を加えています。
3. 最後のプロンプトは、無秩序で色鮮やかな絵の具の飛沫を特徴とする、ジャクソン・ポロックのスタイルに着想を得ています。「raw emotion」や「abstract expressionist」という表現によって、生々しく力強い表現をさらに引き出しています。
3. 最後のプロンプトは、無秩序で色鮮やかな絵の具の飛沫を特徴とする、ジャクソン・ポロックのスタイルに着想を得ています。「raw emotion」や「abstract expressionist」という表現によって、生々しく力強い表現をさらに引き出しています。
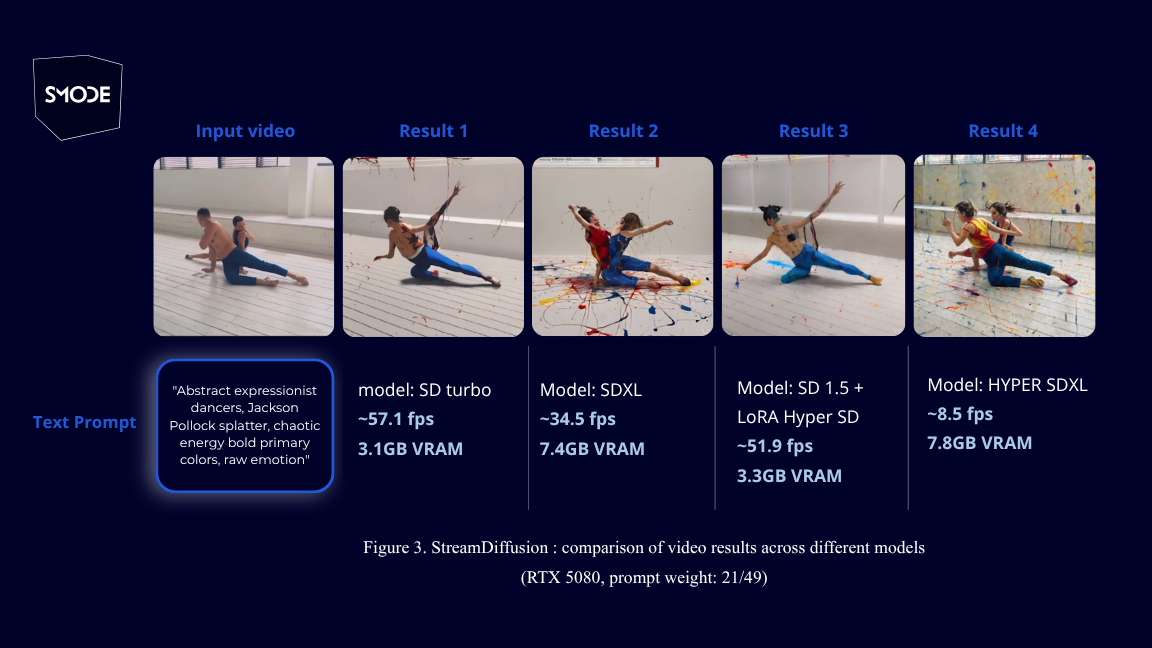
SDXLとHyper SDXLは、細部まで描き込まれた洗練された画像を生成する一方で、処理に時間がかかり、GPUメモリを多く使用します。これに対して、SD TurboやLoRAを組み合わせたSD 1.5は比較的軽量で、リアルタイムに動作し、VRAMの使用量も抑えられます。ただし、生成画像の精緻さは控えめです。
画質と滑らかさのどちらを優先するかによって、適した選択は変わります。
SDXLとHyper SDXLは、細部まで描き込まれた洗練された画像を生成する一方で、処理に時間がかかり、GPUメモリを多く使用します。これに対して、SD TurboやLoRAを組み合わせたSD 1.5は比較的軽量で、リアルタイムに動作し、VRAMの使用量も抑えられます。ただし、生成画像の精緻さは控えめです。
画質と滑らかさのどちらを優先するかによって、適した選択は変わります。
"ライブパフォーマンスにAIを取り入れるということは、今あるツールを自分の手で使いこなし、実験と試行錯誤を通じてAIのエコシステムを探りながら、表現の主導権を自分たちの手に取り戻すことです。"
"ライブパフォーマンスにAIを取り入れるということは、今あるツールを自分の手で使いこなし、実験と試行錯誤を通じてAIのエコシステムを探りながら、表現の主導権を自分たちの手に取り戻すことです。"
実験:輪郭・深度・ポーズによる生成の制御
ControlNetは、画像生成モデルに組み込み、テキストに加えて視覚的な指示を与えるためのツールです。物体の輪郭や人物のシルエットなどの参照情報を渡すことで、生成結果をより細かく制御できます。
ControlNetを使用しない場合は、求める内容を言葉で伝え、モデルがそれを自由に解釈します。ControlNetを使用すれば、たとえば物体の輪郭や人物のポーズを示し、その構造に沿った画像を生成させることができます。
- Canny: 画像の輪郭を検出します。生成結果に元の物体の形状や構造を保ちたい場合に役立ちます。
- Depth: シーン内の要素の距離を解析します。画像の奥行き感や空間構造を保つことができます。
- Pose: 人物の位置や姿勢を検出します。手を除き、元のポーズを生成画像に再現できます。
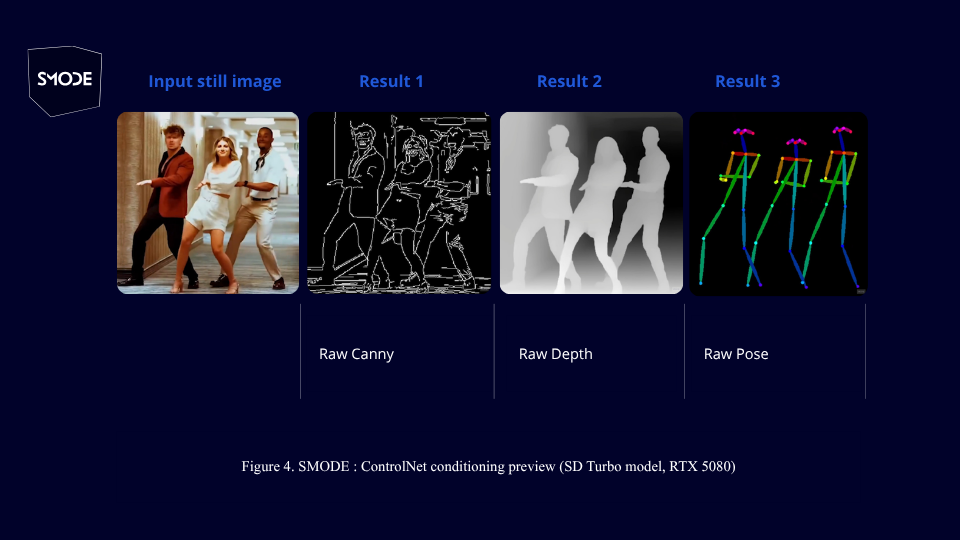
この実験でも映像ストリームを入力に使用し、テキストプロンプトによって、元の映像をより調和の取れた表現へと導きました。
比較画像の1列目には、入力映像を示しています。
2列目は比較の基準です。SD Turboモデルを使用したStreamDiffusionの出力で、視覚的な指示は加えていません。これにより、視覚的なガイドを使わない場合の生成結果を確認できます。
3列目では、Cannyのみを使用しています。元の映像の輪郭がより明確になり、生成結果でも輪郭線がはっきりと強調されています。
4列目では、Depthのみを使用しています。シーン内の要素の深度を解析することで、モデルが前景と背景の関係を捉え、その空間的な配置を生成結果に反映します。
最後の5列目では、CannyとDepthを組み合わせ、両方のガイドの長所を生かした結果を得ています。複数のControlNetガイドを重ねると映像の滑らかさは大きく低下しますが、得られる映像の精緻さに対して、GPUリソースの使用量は妥当な範囲に収まっています。
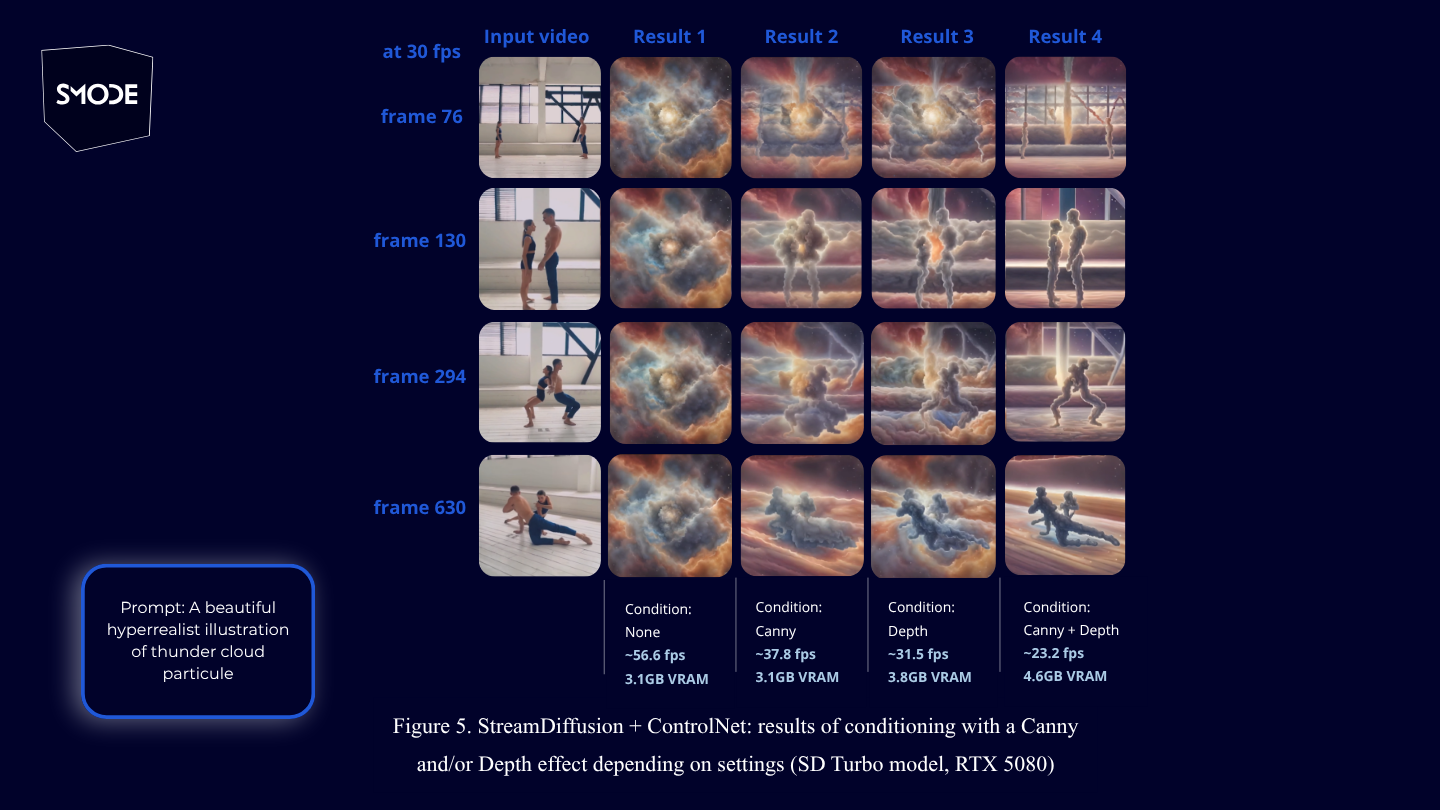
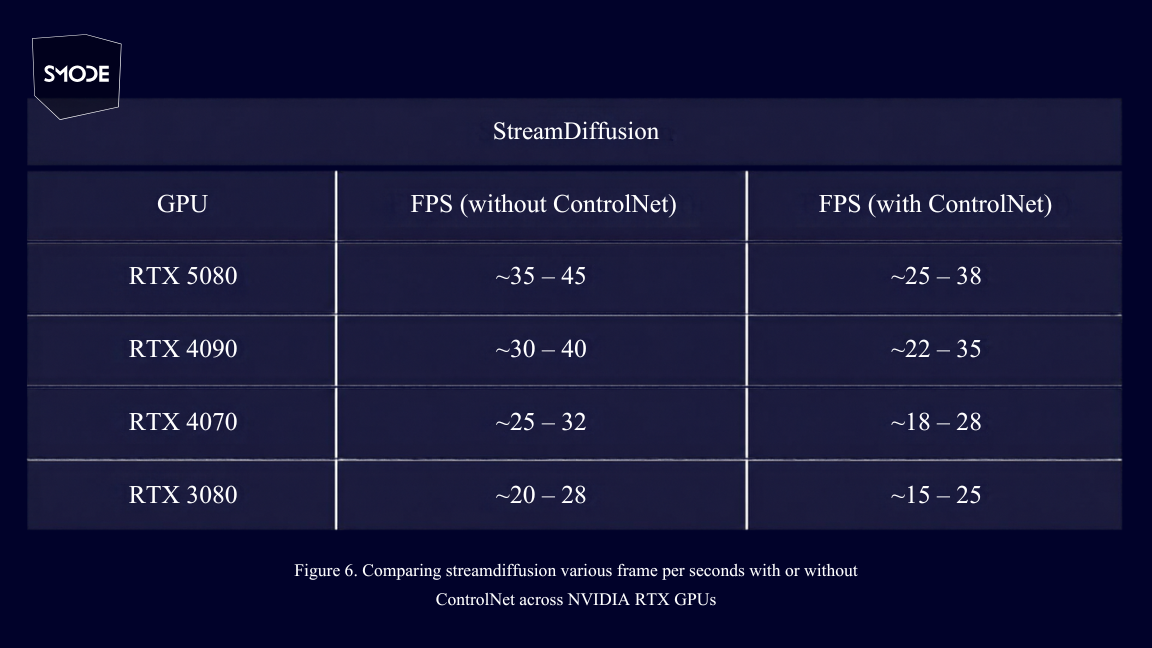
StreamDiffusionやControlNetのようなAIモデルをSMODEに統合する際、中心となる課題は、いかに滑らかで安定したリアルタイム動作を実現するかということです。これらのツールは多くのGPUリソースを必要とし、使用するNVIDIA RTXシリーズのグラフィックスカードによって、特にフレームレート(FPS)に違いが生じます。
今回の検証では、SMODE内でのLoRAとの互換性も取り上げています。LoRAの使い方は目的によって異なり、使用するとGPU負荷もさらに増加します。そのため、画質とGPUリソースの負荷のバランスを考慮する必要があります。
StreamDiffusionのデノイズ処理では、意図的に加えられたノイズを段階的に取り除き、画像を形にしていきます。ステップ数を増やすことで最終的な画質は向上しますが、それに伴ってGPUリソースの使用量も増加します。
SMODE:生成AIコミュニティの発展に向けて
StreamDiffusionが安定した標準ツールとしてSMODEに組み込まれ、Romainのようなユーザーによる実験や検証が積み重なることで、コンテンツ制作ソフトウェアにおける生成AIの新たな表現の可能性が広がります。同時に、こうした取り組みは、生成AIを取り巻くコミュニティを育てるための確かな入り口にもなります。 一方で、このアプローチは標準化や互換性に関する新たな課題も提起します。その一つが、モデルをソフトウェアへ組み込む工程を簡素化することです。モデルはすべて同じ設計で作られているわけではないため、依存関係や実行環境を整え、ハードウェアとの互換性を確保する必要があります。
リアルタイムの制作環境で目指すのは、ソフトウェアへのシームレスな統合、ほぼ即時の処理、そして妥当なGPUリソースの範囲内で実現できる、できる限り高い画質です。
クレジット
-
執筆: Manu Cheremeh
調査・参考資料:
- StreamDiffusion: A pipeline-level Solution for Real-time Interactive Generation
- Wikipedia — ControlNet、LoRA
- Adding Conditional Control to Text-to-Image Diffusion Models
- NVIDIA TensorRTドキュメント
- Meta AI/Facebook Researchドキュメント
-
画像: Smode Tech、Romain Delaplace — Nocturia Studio、Anthony Ghnassia
協力・謝辞: 本テーマに関する専門的な知見と資料をご提供いただいたRomain Delaplace、貴重なご意見を寄せていただいたJules FouchyとMaxime Cots、記事の構成や見せ方について有益なフィードバックをいただいたMélanie PerezとDaniel Lavigneに、心より感謝いたします。